On-Prem Ticket-KI 2026: Modelle, die auf einer GPU laufen
Open-Weight-Helpdesk-Modelle auf einer Workstation-GPU — was sie können, was sich im letzten Jahr geändert hat, was 24 GB vs. 48 GB kosten, und warum Chatbots an parallelen Sessions scheitern.
On-Prem Ticket-KI 2026: Modelle, die auf einer GPU laufen
📖 10 Minuten Lesezeit • Aktualisiert am 26. August 2026
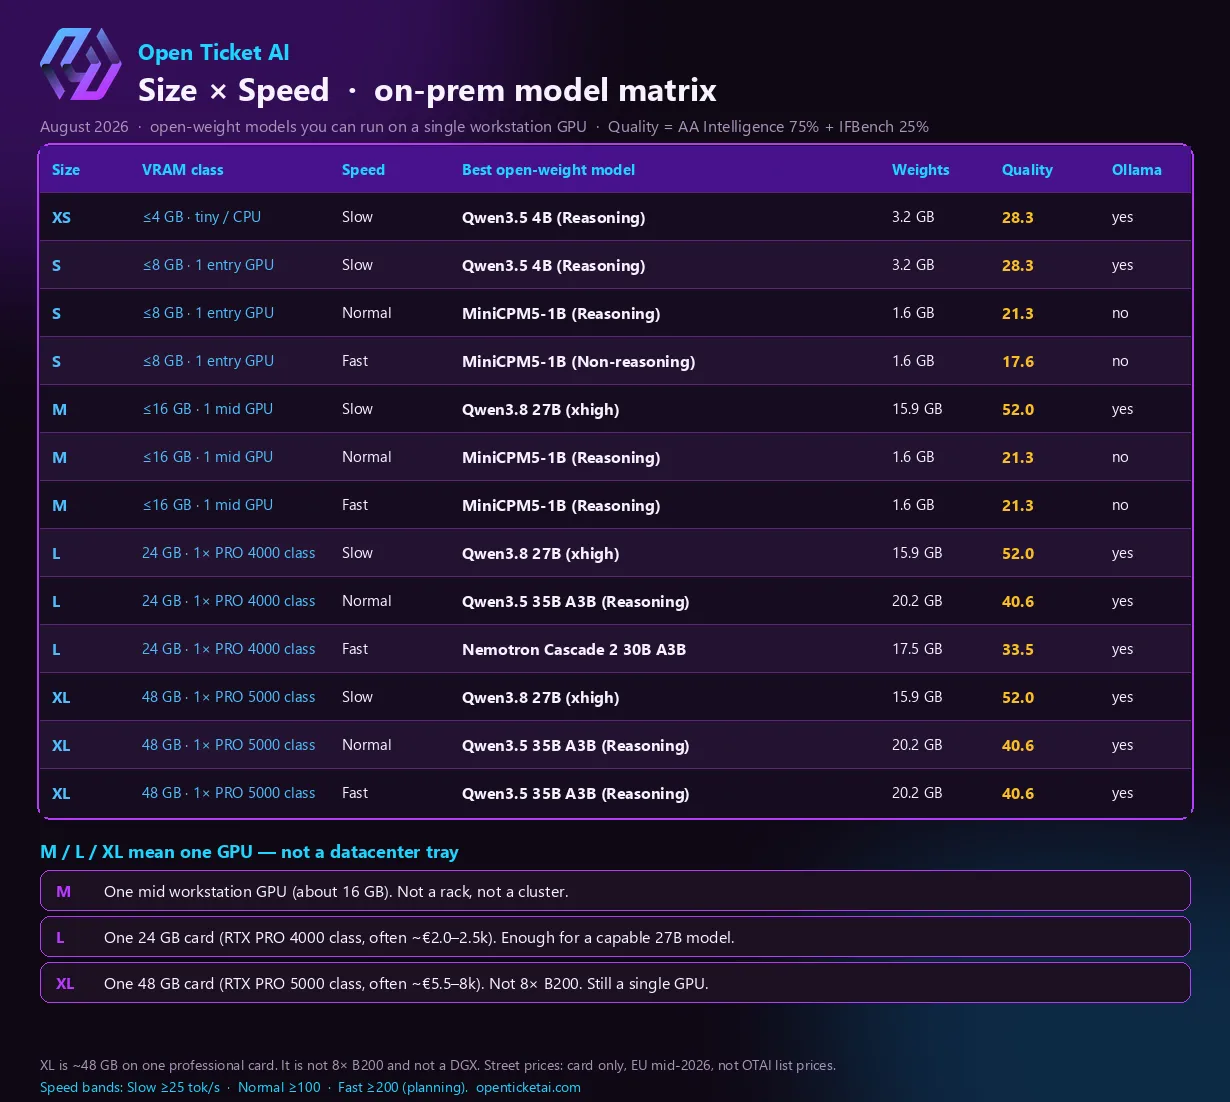
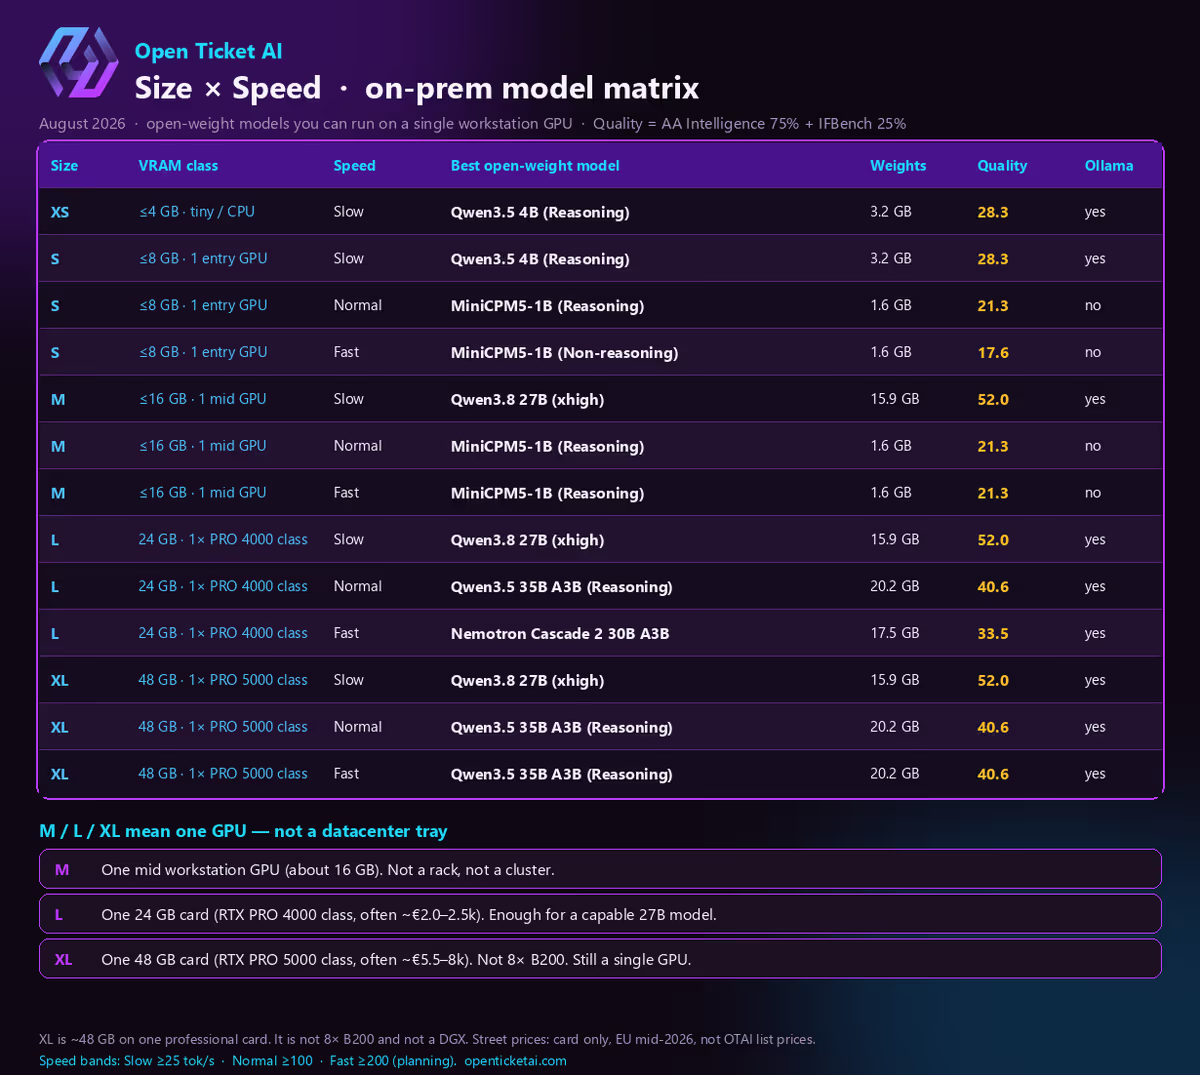
Stand August 2026. M, L und XL sind eine Workstation-GPU (rund 16 GB, 24 GB und 48 GB). Das ist kein Rack voller B200.
Sie brauchen kein Rechenzentrum-Cluster, um nützliche Ticket-KI auf dem eigenen Server zu betreiben. 2026 passen die Modelle, die im Helpdesk zählen — Routing, Priorität, andere strukturierte Felder, Zusammenfassungen — auf eine professionelle GPU unter dem Schreibtisch oder in einer 1U-Kiste neben OTOBO, Znuny, Zammad oder KIX.
Das ist die praktische Aussage der Matrix oben. Die Namen (Qwen, MiniCPM, Nemotron) sind Open Weight. Sie laden lokal. Tickettexte bleiben im Netz. Open Ticket AI Full On-Prem ist genau dafür gebaut; der Free Cloud Trial dient nur dazu, das Produkt zu testen, bevor Sie eine Karte kaufen.
XL in der Tabelle heißt nicht „8× B200“. Es ist eine ~48-GB-Workstation-GPU. L ist eine ~24-GB-Karte. M ist eine mittlere GPU um 16 GB. Wenn Sie ein Hyperscale-Tray vor Augen hatten: eine Größenordnung kleiner denken, und die Rechnung ebenfalls.
Was sich im letzten Jahr geändert hat
Vor einem Jahr hieß „ernsthaft on-prem“ noch: entweder eine gehostete API oder ein knappes 7B/8B-Modell, das bei langen Tickets und striktem Ausgabeformat schwächelte. Zwei Verschiebungen kamen zusammen.
Die Modelle wurden für dieselbe Aufgabe kleiner. Mixture-of-Experts (das A3B in Namen wie Qwen3.5 35B A3B) hält viele Gesamtparameter, aktiviert pro Token aber nur wenige Milliarden. Die Qualität rückt an große dichte Modelle heran, die Decode-Kosten eher an ein mittelgroßes. Dichte 27B-Gewichte, quantisiert, liegen in 24 GB plus Kontext.
Open Weights sind spürbar besser geworden. Familien wie Qwen 3.5 / 3.8 und NVIDIAs Nemotron-Linie haben die Lücke geschlossen, die Teams früher zur geschlossenen API getrieben hat, sobald „Anweisungen befolgen“ Pflicht war. Öffentliche Komposits sind keine Ticket-Prüfung, aber sie reichen für die Aussage: ein lokales 27B in 2026 ist nicht das lokale 7B von 2024.
Hardware ging in die andere Richtung. Workstation-Blackwell mit 24 GB und 48 GB ist ein normaler IT-Kauf, kein Forschungssonderfall. Flagship 96 GB und jedes B200-Cluster sind ein anderes Budget — nützlich für Labs, unnötig für die meisten Service Desks.
Was diese Modelle auf Ihrem Server können
Im Helpdesk sind die nützlichen Jobs langweilig und hochvolumig:
| Aufgabe | Warum ein lokales Modell reicht | Status in Open Ticket AI |
|---|---|---|
| Klassifizieren von Routing-Ziel, Priorität, Typ, anderen Einfachauswahl-Feldern | Kurze Ausgabe, muss Ihre Feldliste treffen | Verfügbar |
| Zusammenfassen eines Threads, damit die nächste Person nicht 40 Notizen liest | Braucht Instruction Following, keinen 70B-Essayisten | Verfügbar |
| Title Rewrite / Feldextraktion | Dieselbe Klasse, strengeres Format | Im Produkt, nicht die Headline |
| Kunden-Chatbot / Antwortentwürfe | Lange Generierungen, viele Menschen warten gleichzeitig | Coming soon |
Nichts davon ist „Ticket selbst schließen“. Menschen bleiben in der Kontrolle. Das Modell füllt Felder und kurzen Text, die Queue läuft.
Die Gewinner vom August 2026 legen sich so auf die Jobs:
- Qwen3.8 27B — die Qualitätswahl ab etwa 16–24 GB. Das ist die Klasse, bei der Klassifikation und Summaries wie ein heutiger Assistent wirken, nicht wie ein Spielzeug.
- Qwen3.5 35B A3B — mehr Durchsatz auf 24–48 GB, ohne ein riesiges dichtes Modell.
- Nemotron Cascade 2 30B A3B — die 24-GB-Wahl, wenn mehrere Jobs gleichzeitig laufen sollen.
- Qwen3.5 4B — die ehrliche Antwort für 4–8 GB: es läuft, es erreicht nicht 27B-Qualität.
- MiniCPM5-1B — klein und schnell. Sinnvoll, wenn Concurrency wichtiger ist als Peak-Qualität; prüfen Sie, ob Sie es lokal ziehen und serven können.
Qualität in der Abbildung ist ein öffentlicher Komposit (Artificial Analysis Intelligence Index 75 % + IFBench 25 %). Das ist ein Rangsignal, kein „52 % Ihrer Tickets stimmen“.
Hardware: was M, L und XL wirklich kosten
Straßenpreise unten gelten nur die GPU-Karte, europäische Listings Mitte/Ende 2026. Das sind keine Open-Ticket-AI-Softwarepreise (Full On-Prem ist On Request). Ein kompletter Node (Gehäuse, CPU, RAM, Netzteil, Kühlung) kostet mehr; viele Teams haben den Host schon und legen nur die Karte nach.
| Matrix-Size | Was viele hören | Was es wirklich ist | Typische Kartenklasse | Karten-Band (EU) |
|---|---|---|---|---|
| M | „mittlere KI-Kiste“ | Eine ~16-GB-GPU | Mittlere Workstation / 16 GB | Meist klar unter einer 24-GB-Profi-Karte |
| L | „Large = Cluster“ | Eine 24-GB-GPU | RTX PRO 4000 Blackwell | Etwa 2,0–2,5 Tsd. € (aktuelle Tiefs nahe 2,1 Tsd. €) |
| XL | „XL = 8× B200“ | Eine 48-GB-GPU | RTX PRO 5000 Blackwell | Etwa 5,5–8 Tsd. €, Shop und MwSt. schwanken |
| (nicht in dieser Matrix) | „richtiger KI-Server“ | Eine 96-GB-GPU | RTX PRO 6000 Blackwell | Oft 13–16 Tsd. €+ — immer noch eine Karte, immer noch nicht acht B200 |
Ein voller S-Produktionsnode (24-GB-Karte plus leiser Tower oder kleine 1U) landet oft grob bei 4,5–7,5 Tsd. € Hardware, Host eingerechnet. Das ist der übliche Full-On-Prem-Start: Klassifikation und Summaries für einen echten Desk, bei Ihnen.
B200-Systeme sind ein anderer Markt (Multi-GPU-Trays, Rechenzentrumsstrom, sechsstellige Gespräche). Nichts in dieser Matrix setzt das voraus. Wenn Facility „XL-Katalog“ gehört und einen Käfig reserviert hat, können Sie entwarnen.
Mehr Sizing: On-Prem Ticket-KI: Welche GPU Sie brauchen.
24 GB tragen schon ein fähiges Modell — weh tut der Chat
Das ist der Satz, den Käufer vertauschen.
Auf 24 GB (Matrix L) läuft schon ein deutlich fähigeres Modell als die 7B-Generation: Qwen3.8-27B-Klasse für Qualitätsarbeit, oder ein MoE-30B, wenn Sie mehr Tokens pro Sekunde wollen. Klassifikation und Summaries erzeugen keine langen Antworten. Die Jobs sind kurz. Ein paar Tickets gleichzeitig sind normal. Eine 24-GB-Karte ist dafür der richtige Default.
Ein Kunden-Chatbot ändert die Rechnung. Jeder offene Chat hält wachsenden Kontext (KV-Cache) und streamt Tokens, bis die Person fertig ist. Zehn Menschen, die gleichzeitig auf eine Antwort warten, sind nicht „zehn Klassifikationen“. Es sind zehn lange Generierungen in einem Speicherpool. Das ist das Skalierungsproblem:
- Qualitätsmodell + viele parallele Chats → die 24-GB-Karte läuft voll oder die Warteschlange wächst.
- Winziges schnelles Modell + viele Chats → die Queue läuft, die Antworten werden dünner.
- Mehr VRAM (48 GB, Matrix XL) oder eine zweite GPU → mehr residenter Kontext, mehr parallele Streams — immer noch ein Server, kein B200-Pod.
Solange Chatbot und Antwortentwürfe nicht die Live-Headline sind: 24 GB für die Arbeit, die heute ausgeliefert wird, 48 GB als Reserve, wenn Sie schon wissen, dass Portal-Chat voll wird. Kaufen Sie kein Cluster, weil in der Katalogzeile XL steht.
Die Tabelle ohne Überbau nutzen
- Strukturierte Ticket-KI (klassifizieren + zusammenfassen): planen Sie L / 24 GB. Dort lebt das fähige 27B-Klassen-Modell.
- Nur 8 GB: lokal geht es (4B-Klasse). Schwächere Qualität. Labor ja, Produktion dünn.
- Portal-Chat mit vielen Wartenden: Qualitätsmodell für schwere Turns, kleineres/schnelleres Modell für günstige Turns, oder 48 GB. Messen Sie parallel wartende Nutzer, nicht offene Browser-Tabs.
- Für einen kurzen Pilot: Modelle mit Ollama „yes“ in der Abbildung.
- Auf Ihrer Kiste nachmessen. Öffentliche Scores und Planungs-Durchsatz sind nicht
llama-benchmit Ihrer Quantisierung und Context-Länge.
Evaluieren Sie im Free Cloud Trial, dann Full On-Prem auf Ihrer GPU, wenn Ticketinhalt im Gebäude bleiben muss.
Quellen
- Open Ticket AI Models-Catalog-Evaluation, Stand 17. August 2026 — öffentliche Open-Weight-Rangfolge für On-Prem-Sizing (keine private Ticket-Prüfung).
- Artificial Analysis und IFBench — öffentliche Qualitätssignale in der Abbildung.
- EU-Straßenpreise (nur Karte, Mitte 2026; Shops bewegen sich): RTX PRO 4000, RTX PRO 5000, RTX PRO 6000.
- Ollama Library — Bequemlichkeit, kein Qualitätsscore.
- Weiter: GPU-Hardware und Kosten, Ollama + Zammad AI, Produkteditionen.